00 · 연구 산출물 — 직접 체험하고 반응을 남겨 주세요
나를 따라 하는 로하 2종, 로하와 대화하기 2종
같은 캐릭터를 서로 다른 방식으로 구현한 네 가지 산출물이다. 체험 후 실재감·재미·재이용 의향을 남겨 주시면 방식별 반응을 비교하는 자료로 쓴다(익명, 영상·개인정보는 수집하지 않음).
01 · 연구 배경과 목적
팬이 아이돌을 ‘보는’ 데서 ‘함께 움직이는’ 경험으로
가상 아이돌과 버추얼 크리에이터 시장이 커지면서, 아바타는 미리 제작된 영상을 재생하는 존재에서 관객과 실시간으로 상호작용하는 존재로 바뀌고 있다. 그러나 실시간 아바타를 구동하려면 대개 모션캡처 장비, 고사양 GPU 서버, 전용 앱이 필요하여 일반 이용자가 접근하기 어렵다.
본 연구는 AIForA Lab이 운영하는 AI 아바타 걸그룹 PinkPop의 멤버 로하를 대상으로, 별도 장비 없이 웹캠과 웹 브라우저만으로 사용자의 전신 동작·손동작·얼굴 표정을 실시간으로 따라 하는 3D 아바타를 구현하는 것을 목적으로 한다.
사람과 구별하기 어려운 얼굴·피부·머리카락
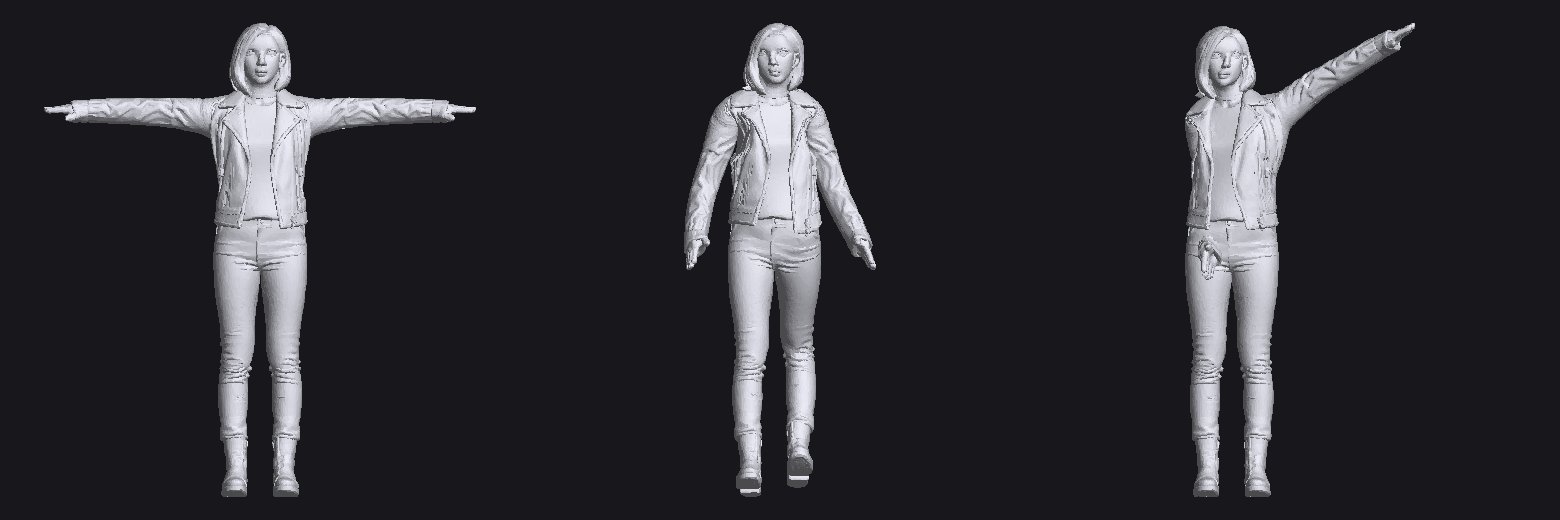
평면 영상이 아닌 3차원 인물 — 조명과 시점 변화에 반응
팔다리·손가락·표정까지 사용자의 움직임을 실시간 재현
02 · 선행연구
네 갈래의 기존 접근
| 갈래 | 대표 연구·도구 | 강점 | 한계 |
|---|---|---|---|
| 단안 카메라 인체·얼굴 추적 | BlazePose [1], MediaPipe Face Mesh [2], Blendshape 추정 [3] | 휴대 기기에서도 실시간, 표정 계수 52종 추정 | 추적 결과를 담을 사실적인 아바타는 별도로 필요 |
| 얼굴 재연(2D 이미지 애니메이션) | First Order Motion Model [4], LivePortrait [5] | 사진 한 장으로 사실적인 표정 재현 | 얼굴 영역만 움직이고 입체성·전신 동작이 없음, GPU 필요 |
| 포즈 조건 영상 생성 | Animate Anyone [6] | 전신 동작까지 사실적인 영상 생성 | 수 분 단위의 생성 시간 — 실시간 상호작용 불가 |
| 3D 인체 모델·디지털 휴먼 | SMPL [7], Rodin [8], 3D Gaussian 아바타 [9], MetaHuman | 입체적이며 뼈대로 실시간 구동 가능 | 사실적인 품질에는 전문 제작 도구·게임 엔진·고사양 장비가 필요 |
03 · 선행연구의 한계
세 조건을 동시에, 그리고 누구나 쓸 수 있게
기존 접근은 실사성·입체성·동작 추종·실시간성 중 일부만 충족한다. 본 연구에서 직접 구현해 비교한 결과도 같았다.
| 본 연구에서 구현한 방법 | 실사성 | 입체성 | 동작 추종 | 실시간 | 관찰 |
|---|---|---|---|---|---|
| 사진 기반 3D 메시 + 자동 리깅 | ✗ | ✓ | ✓ | ✓ | 동작은 정확하나 인형과 같은 인상 |
| 실사 대화 아바타 (LiveAvatar) | ✓ | ✗ | ✗ | ✓ | 대화는 자연스러우나 사용자 동작을 따르지 않음 |
| 얼굴 재연 (LivePortrait) | ✓ | ✗ | 얼굴 | ✓ | 표정은 실사로 추종, 팔다리는 정지 |
| 모션 전이 (녹화 후 변환) | ✓ | ✗ | ✓ | ✗ | 결과까지 수 분 대기 |
| 제안 A — 실사 3D 캐릭터 + 브라우저 추적 | 중간 | ✓ | ✓ | ✓ | 손가락까지 추종, 웹 렌더링의 피부·머리카락 표현이 한계 |
| 제안 B — 정체성 학습 사진 + 얼굴 재연 | ✓ | ✗ | 얼굴 | ✓ | 사진 품질의 표정·고개 추종. 사진 인형으로 몸까지 움직이는 방식은 종이를 오려 붙인 인상이 남아 채택하지 않음 |
연구 질문. 전문 제작 도구로 만든 실사 3D 캐릭터와 브라우저 기반 단안 추적을 결합하면, 별도 장비와 서버 GPU 없이도 실사성·입체성·동작 추종을 실시간으로 동시에 달성할 수 있는가?
04 · 새로운 방법론의 설계
캐릭터는 전문 도구로, 추적과 렌더링은 브라우저에서
로하 정면 사진을 Headshot으로 3D 얼굴에 옮기고, Character Creator에서 전신·피부·머리카락을 구성한다. 손가락 뼈와 얼굴 표정 키를 포함해 내보내고, 웹용으로 표정 키 66종만 남겨 경량화한다.
MediaPipe로 몸 33점(3차원 월드 좌표), 양손 21점, 얼굴 표정 계수 52종을 브라우저에서 추정한다. 표정 계수 52종은 대응표를 거쳐 캐릭터의 표정 키로 연결되며, 턱과 눈동자는 뼈 회전으로 구동한다.
화면을 거울처럼 보이도록 좌우를 바꾸고, 팔다리는 관절 방향으로, 몸통·머리는 두 축의 좌표틀로 회전을 계산한다. 뼈 이름을 느슨하게 찾아 맞추므로 캐릭터를 바꿔도 코드가 그대로 쓰인다.
관절·손가락·표정 계수에 One Euro 필터를 적용해 떨림을 줄이고, 화면 밖 관절은 편안한 자세로 채운다. 이용자별 무표정 기준값을 1~2초간 학습해 안경·눈매로 인한 표정 편향을 제거한다.
제안 B — 사진의 실사성을 그대로 유지하는 경로
로하 사진 8장으로 이미지 생성 모델(Higgsfield SOUL)에 인물 정체성을 등록하고, 같은 얼굴의 정면 얼굴·전신 사진을 생성한다. 머리 색, 점, 피어싱 등 캐릭터 고유 특징이 유지된다.
전신 사진을 12,936개 격자로 덮고 뼈 10개로 휘게 하여 몸 동작까지 따라 하게 하는 방식을 시험하였다. 동작은 추종되었으나 한 장의 사진을 변형하는 한계로 옷과 팔의 경계가 종이를 오려 붙인 듯 드러나, 실사성을 해치는 것으로 판단해 제외하였다.
얼굴 부근만 LivePortrait로 재연해 고개 회전과 표정을 사진 품질 그대로 만들고, 브라우저가 이를 움직이는 사진의 얼굴 자리에 덧입힌다. 서버는 도커 컨테이너에서 GPU 4장으로 동시 4명을 처리한다.
공개 산출물은 네 가지이다. 따라 하기는 실사성을 우선한 ‘실사 얼굴’(제안 B)과 동작 범위를 우선한 ‘게임 캐릭터 전신’(제안 A)으로, 대화는 ‘1:1’과 ‘그룹’으로 나누어 방식별 이용자 반응을 비교한다.
대화 경로 — 따라 하기를 넘어 함께 이야기하기
실시간 대화형 아바타(LiveAvatar)에 로하의 사진·목소리·성격을 입혀, 이용자의 음성을 듣고 로하가 입 모양과 표정을 맞추어 답한다. 세션 발급은 서버에서만 이루어지며 이용 횟수를 제한해 비용을 관리한다.
05 · 데이터 수집과 결과
지금까지의 측정 결과

수집할 데이터
체험 페이지는 영상을 저장하지 않는다. 대신 이용자가 동의한 경우에 한해 다음의 익명 지표만 수집하도록 설계한다.
프레임 속도, 추적 지연, 추적 끊김 비율, 기기 종류
사용자 관절 방향과 아바타 뼈 방향의 각도 오차
실재감·동일시·흥미에 대한 짧은 설문(체험 후 선택 응답)
06 · 가치 제안
누구에게 어떤 가치를 주는가
앱 설치나 장비 없이, 링크 하나로 좋아하는 아이돌과 함께 춤추고 표정을 주고받는 경험
모션캡처 스튜디오 없이 웹캠으로 아바타 공연·방송을 제작하고, 캐릭터만 바꿔 다른 멤버에 재사용
서버 GPU 없이 접속자 수만큼 확장되는 실시간 아바타 — 비대면 수업, 재활·운동 코칭, 인간-아바타 상호작용 연구의 실험 도구
개인정보 측면에서는 얼굴·신체 영상이 기기를 떠나지 않는 구조 자체가 가치이다. 운영 측면에서는 처리 비용이 이용자 기기에 분산되어, 접속자가 늘어도 서버 비용이 거의 늘지 않는다.
07 · 소프트웨어 아키텍처
브라우저 · 연구 서버 두 대 · 외부 서비스로 나눈 구조
처리 부담이 큰 추적과 3D 렌더링은 방문자의 브라우저가 맡고, 서버는 사진 품질의 표정 합성과 대화 세션 발급처럼 브라우저가 할 수 없는 일만 맡는다. 서버 쪽 작업은 모두 컨테이너 또는 기존 웹 서버 안에서 돌며, 방문자의 영상은 어디에도 저장하지 않는다.
| 구성 요소 | 기술 | 역할 | 위치 |
|---|---|---|---|
| 단안 추적 | MediaPipe Pose·Face·Hand Landmarker | 관절·손가락·표정 계수 추정, 떨림 필터 | 브라우저 |
| 리타기팅·렌더링 | three.js, pose_rig.js | 뼈 회전·표정 키 구동, 무대 조명·확대 화면 | 브라우저 |
| 게이트웨이 | nginx (도커) | HTTPS, 정적 파일, WebSocket 프록시 | 루멘 |
| 얼굴 재연 서버 | aiohttp, PyTorch, LivePortrait (도커, GPU 4) | 사진 품질의 표정·고개 합성, 동시 4명 | 루멘 |
| 대화 세션 발급 | PHP, LiveAvatar API | API 키 보호, 호출 제한 | aiforalab |
| 반응 수집 | PHP, MySQL | 익명 점수·의견 저장, 요약 통계 | aiforalab |
| 캐릭터 제작 | Higgsfield SOUL, Reallusion Character Creator 5·Headshot 3, Blender | 정체성 유지 사진, 3D 캐릭터(얼굴·머리카락·의상·뼈대·표정 키), 웹 변환 | 연구실 PC |
사용한 도구와 서비스
- Reallusion — Character Creator 5(3D 인물 제작·의상·머리카락·표정 키), Headshot 3(사진 한 장으로 3D 얼굴 재구성). 게임 캐릭터 로하의 원본을 만들었다.
- Higgsfield — SOUL 정체성 학습·이미지 생성(로하의 정면 얼굴·전신 사진).
- Blender — FBX를 웹용 GLB로 헤드리스 변환(표정 키 선별, WebP 텍스처).
- Google MediaPipe — 브라우저 안의 몸·손·얼굴 추적.
- three.js — WebGL 3D 렌더링.
- LivePortrait — 사진 기반 얼굴 재연(루멘 GPU 서버).
- LiveAvatar — 실시간 대화 아바타(음성 인식·대화·음성 합성·입 모양).
개인정보 원칙: 몸 동작 영상은 기기를 떠나지 않는다. 얼굴 영상은 표정 합성을 위해서만 루멘으로 전송되며 메모리에서 처리 후 즉시 폐기된다. 반응 설문은 동의한 경우에만 익명으로 저장한다.
네 가지 로하를 만나 보세요
따라 하기 두 가지(실사 얼굴, 게임 캐릭터 전신)와 대화 두 가지(1:1, 그룹)입니다. 몸 동작은 기기 안에서만 처리되고, 실사 얼굴 영상은 표정을 만들기 위해 연구 서버로 전송된 뒤 즉시 폐기됩니다(저장하지 않음). 체험 후 맨 위 ‘00’에서 반응을 남겨 주세요.
참고문헌
- Bazarevsky, V. et al. (2020). BlazePose: On-device Real-time Body Pose Tracking. arXiv:2006.10204.
- Kartynnik, Y. et al. (2019). Real-time Facial Surface Geometry from Monocular Video on Mobile GPUs. arXiv:1907.06724.
- Grishchenko, I. et al. (2023). Blendshapes GHUM: Real-time Monocular Facial Blendshape Prediction. arXiv:2309.05782.
- Siarohin, A. et al. (2019). First Order Motion Model for Image Animation. NeurIPS 2019.
- Guo, J. et al. (2024). LivePortrait: Efficient Portrait Animation with Stitching and Retargeting Control. arXiv:2407.03168.
- Hu, L. et al. (2024). Animate Anyone: Consistent and Controllable Image-to-Video Synthesis for Character Animation. CVPR 2024.
- Loper, M. et al. (2015). SMPL: A Skinned Multi-Person Linear Model. ACM Transactions on Graphics, 34(6).
- Wang, T. et al. (2023). Rodin: A Generative Model for Sculpting 3D Digital Avatars Using Diffusion. CVPR 2023.
- Hu, L. et al. (2024). GaussianAvatar: Towards Realistic Human Avatar Modeling from a Single Video via Animatable 3D Gaussians. CVPR 2024.
- Casiez, G., Roussel, N., & Vogel, D. (2012). 1€ Filter: A Simple Speed-based Low-pass Filter for Noisy Input in Interactive Systems. CHI 2012.
- Jacobson, A. et al. (2014). Skinning: Real-time Shape Deformation. ACM SIGGRAPH 2014 Courses.